Recherche dichotomique en C : première occurrence
Écris une recherche dichotomique en C avec des bornes [lo, hi), suis chaque étape et traite les doublons, le tableau vide et la valeur absente.
Ton tableau est trié, mais ta recherche dichotomique rate le dernier élément ou boucle sur deux cases. Puis tu ajoutes des doublons : trouver un 4 ne suffit plus, tu veux le premier.
En bref
Pour trouver la première occurrence par recherche dichotomique en C, pars de lo = 0 et hi = n, avec hi exclu. Tant que lo < hi, calcule mid = lo + (hi - lo) / 2 : si a[mid] < key, avance lo à mid + 1 ; sinon, ramène hi à mid. À la fin, lo est la première position dont la valeur serait supérieure ou égale à key. Vérifie lo < n puis a[lo] == key avant de conclure.
Que représentent les bornes lo et hi ?
[lo, hi) contient les indices encore à examiner : lo est inclus, hi est exclu. Pour sept éléments, on commence avec [0, 7). Le dernier indice lisible reste 6. La position 7 sert de borne, elle n'est jamais une case à lire.
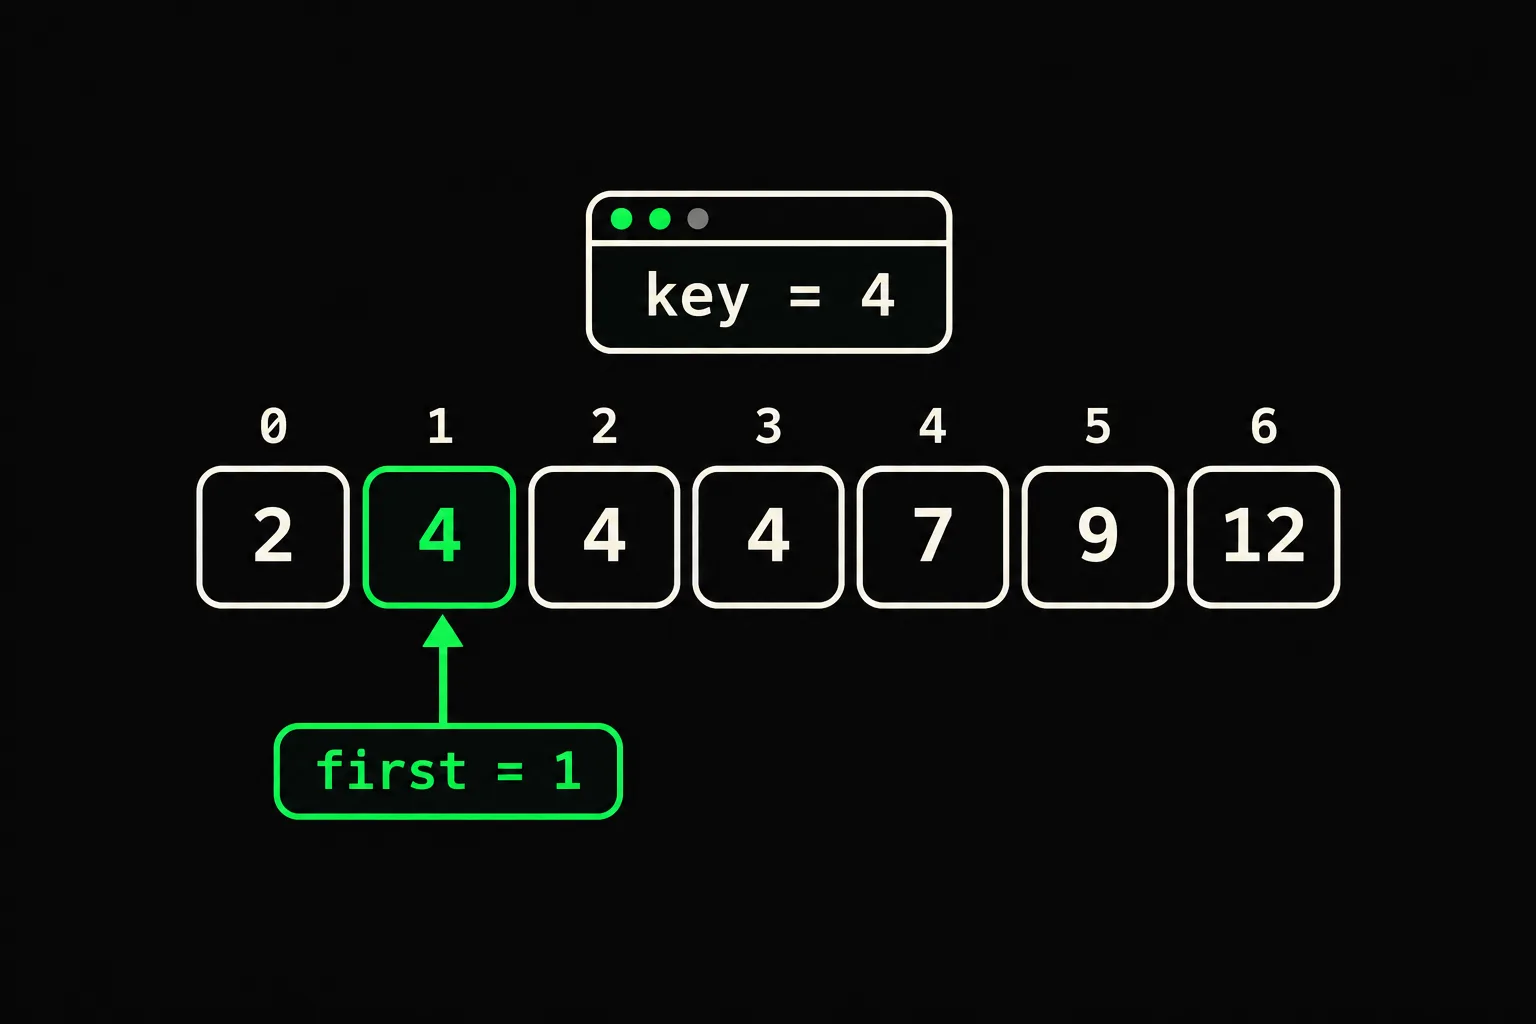
Voici le tableau que nous allons parcourir. Les trois 4 sont égaux, mais seul celui d'indice 1 répond à la question « où commence la série ? ».
- 02
- 14premier 4
- 24
- 34
- 47
- 59
- 612
Le tableau doit être trié par ordre croissant, avec des doublons autorisés. L'algorithme s'appuie sur cet ordre pour éliminer des valeurs sans les lire. Il ne vérifie pas le tri à chaque recherche : parcourir tout le tableau pour le vérifier coûterait déjà un temps linéaire.
Comment les bornes se resserrent-elles pour chercher 4 ?
La première comparaison lit l'indice 3, qui contient 4. On garde la possibilité d'un 4 plus à gauche en posant hi = 3. L'égalité ne termine donc pas la recherche.
Étape 1 sur 4
Comparer l'indice 3
- lo
- 0
- hi
- 7
- mid
- 3
- 02
- 14
- 24
- 34mid
- 47
- 59
- 612
4 est égal à la cible. La première occurrence est à l'indice 3 ou avant : hi devient 3.
Lire toutes les étapes
1. Comparer l'indice 3
- lo
- 0
- hi
- 7
- mid
- 3
- 02
- 14
- 24
- 34mid
- 47
- 59
- 612
4 est égal à la cible. La première occurrence est à l'indice 3 ou avant : hi devient 3.
2. Comparer l'indice 1
- lo
- 0
- hi
- 3
- mid
- 1
- 02
- 14mid
- 24
- 34hors intervalle
- 47hors intervalle
- 59hors intervalle
- 612hors intervalle
Encore 4. On cherche une occurrence plus à gauche : hi devient 1.
3. Comparer l'indice 0
- lo
- 0
- hi
- 1
- mid
- 0
- 02mid
- 14hors intervalle
- 24hors intervalle
- 34hors intervalle
- 47hors intervalle
- 59hors intervalle
- 612hors intervalle
2 est inférieur à 4. Cette case ne peut pas convenir : lo devient 1.
4. Vérifier la position finale
- lo
- 1
- hi
- 1
- result
- 1
- 02inférieur à 4
- 14premier 4
- 24
- 34
- 47
- 59
- 612
lo == hi : la boucle est terminée. lo < n et a[lo] == 4 confirment la première occurrence à l'indice 1.
« Hors intervalle » veut dire que la boucle n'a plus besoin d'examiner cette case. La borne hi peut encore être la position de la réponse : à l'étape suivante, on cherche seulement si une position plus à gauche convient. L'invariant précis est celui-ci : tout ce qui précède lo est inférieur à key, tout ce qui commence à hi est supérieur ou égal à key. La boucle localise la séparation entre ces deux zones.
Quel code C gère les doublons et le tableau vide ?
La fonction suivante renvoie le premier indice correspondant, ou n quand la valeur est absente. Ce choix garde le résultat dans le type size_t : aucun -1 n'a besoin d'être converti en entier non signé.
#include <stddef.h>#include <stdio.h>
static size_t first_equal(const int a[], size_t n, int key){    size_t lo = 0;    size_t hi = n;
    while (lo < hi) {        size_t mid = lo + (hi - lo) / 2;        if (a[mid] < key)            lo = mid + 1;        else            hi = mid;    }    return lo < n && a[lo] == key ? lo : n;}
static void show(const int a[], size_t n, int key){    size_t index = first_equal(a, n, key);    if (index == n)        printf("key=%d: not found\n", key);    else        printf("key=%d: index=%zu\n", key, index);}
int main(void){    int values[] = {2, 4, 4, 4, 7, 9, 12};    size_t n = sizeof values / sizeof values[0];
show(values, n, 4); show(values, n, 6); show(values, n, 2); show(values, n, 12); show(NULL, 0, 4); return 0;}$ gcc -std=c17 -Wall -Wextra -Werror search.c -o search$ ./searchkey=4: index=1key=6: not foundkey=2: index=0key=12: index=6key=4: not foundn doit être le nombre d'éléments réellement accessibles à partir de a. Pour n > 0, le pointeur doit désigner ce tableau. Avec n == 0, la boucle ne démarre pas et le && final s'arrête après lo < n, qui est faux : a[lo] n'est pas évalué. C'est ce qui autorise l'appel first_equal(NULL, 0, 4) dans ce programme.
La valeur 6 illustre un autre piège : la boucle trouve sa position d'insertion, l'indice 4, qui contient 7. Seul le test d'égalité final permet d'annoncer « absent ». Si la cible dépasse toutes les valeurs, lo vaut n et aucune case n'est lue.
Pourquoi mid + 1 d'un côté et mid de l'autre ?
Quand a[mid] < key, l'indice mid est trop petit et doit sortir de la zone à examiner. Quand a[mid] >= key, il peut marquer le début de la zone supérieure ou égale : on le garde comme borne droite.
a[mid] < key ?
Oui
lo = mid + 1
a[mid] et toutes les valeurs avant sont trop petites. La prochaine recherche commence après mid.
Non, y compris l'égalité
hi = mid
mid peut être la séparation cherchée. Examine les indices précédents pour trouver la première occurrence.
Avec lo < hi, le milieu vérifie lo <= mid < hi. Chaque branche réduit donc strictement hi - lo. Écrire lo = mid peut bloquer : quand il reste une case, mid == lo et la borne n'avance plus. Écrire hi = mid - 1 mélange la convention avec borne droite incluse et celle utilisée ici. Avec size_t, soustraire 1 à zéro produit en plus une très grande valeur non signée.
La formule lo + (hi - lo) / 2 évite de calculer lo + hi, dont la somme peut dépasser la capacité du type. Sous l'invariant lo <= hi, la soustraction est valide et le résultat ne dépasse pas hi.

binary_search
Adapte ce raisonnement à une séquence accessible par le callback at(i). L'exercice demande le premier indice, un retour -1 si la valeur manque et au plus 24 lectures pour un million d'éléments. Le contrat diffère de first_equal : respecte la signature fournie et compte aussi la lecture de vérification finale.
Quand préférer bsearch ou une recherche linéaire ?
bsearch, déclarée dans <stdlib.h>, convient si tu veux un pointeur vers une occurrence quelconque. Si plusieurs éléments sont égaux, elle ne garantit pas de renvoyer le premier. Son comparateur suit le principe négatif, nul, positif expliqué dans l'article sur qsort.
Sur un tableau avec accès direct aux éléments, notre boucle fait O(log n) comparaisons et utilise O(1) mémoire supplémentaire. Trier un tableau seulement pour y chercher une fois n'est pas automatiquement rentable : une recherche linéaire peut suffire. En revanche, un tableau déjà trié et consulté souvent se prête bien à la dichotomie. La distinction entre tableau et pointeur, dont dépend le calcul de n, est détaillée dans Tableau ou pointeur en C.
Questions fréquentes
Le tableau peut-il être trié dans l'ordre décroissant ?
Pas avec cette condition. Ici, a[mid] < key élimine la partie gauche parce que les valeurs y sont plus petites ou égales à a[mid]. Pour l'ordre décroissant, il faut revoir le sens des comparaisons et l'invariant.
Pourquoi ne pas renvoyer mid dès que la valeur est trouvée ?
Cela trouve une occurrence, mais pas forcément la première. Dans notre exemple, la première lecture rencontre l'indice 3 alors que la réponse voulue est 1.
Peut-on initialiser hi à n - 1 ?
Oui avec un algorithme qui utilise une borne droite incluse, mais ses mises à jour et sa condition d'arrêt changent. Ne remplace pas seulement l'initialisation dans ce code. Pour un tableau vide, n - 1 déborde aussi en arithmétique non signée.
La recherche fonctionne-t-elle sur une liste chaînée ?
Le milieu n'y est pas accessible en temps constant par un indice. Compter seulement les comparaisons masque alors le coût des déplacements entre nœuds. La complexité donnée ici concerne un tableau avec accès direct.
Sources