Python split() vs split(" ") : quelle différence ?
Choisis entre split() et split avec un espace : espaces multiples, tabulations, champs vides et maxsplit, avec des exemples et un exercice Python.
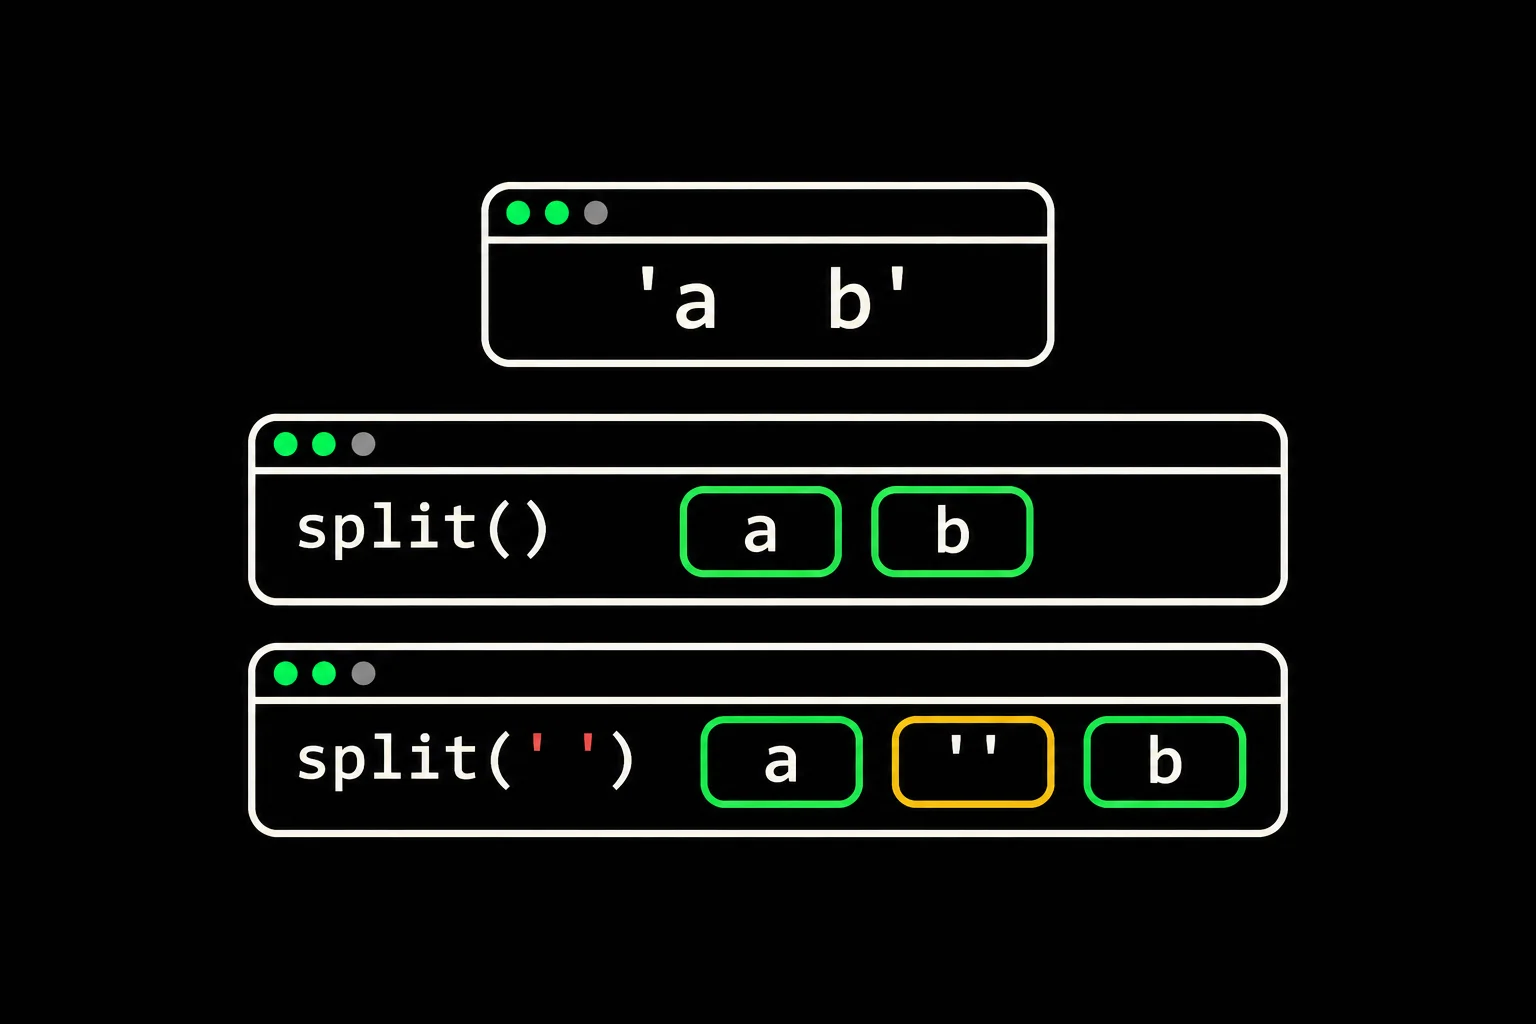
Tu découpes une phrase en mots et tu récupères des chaînes vides au milieu de la liste. Ou une tabulation reste collée à deux mots. L'espace passé à split(" ") change la règle de découpage.
En bref
En Python, text.split() regroupe les caractères d'espacement consécutifs et ne produit pas de champs vides aux extrémités. text.split(" ") coupe uniquement sur le caractère espace : deux espaces consécutifs délimitent un champ vide, et les tabulations restent dans les champs. Choisis le premier pour extraire des mots séparés par des blancs, le second si chaque espace est un délimiteur dont les champs vides ont un sens.
Pourquoi split(" ") laisse des chaînes vides ?
Chaque espace est un séparateur distinct. Une chaîne qui commence par deux espaces commence donc par deux champs vides. Une tabulation, elle, n'est pas le caractère espace demandé.
text = " red blue\tgreen\n"print(repr(text))print(text.split())print(text.split(" "))$ python3 compare.py' red blue\tgreen\n'['red', 'blue', 'green']['', '', 'red', '', 'blue\tgreen\n']La chaîne contient deux espaces avant red, deux entre red et blue, puis une tabulation et un retour à la ligne. repr(text) rend ces derniers visibles ; l'affichage habituel les interprète. Avec split(), ces séparations forment trois mots. Avec split(" "), blue, la tabulation, green et le retour à la ligne restent dans le même champ.
Appeler split() ne modifie pas text. La méthode renvoie une liste de nouvelles sous-chaînes et conserve leur ordre. Tu peux la parcourir directement dans une boucle ; aucune conversion supplémentaire en liste n'est nécessaire.
Que renvoient une chaîne vide et plusieurs séparateurs ?
Sans séparateur explicite, une chaîne vide ou composée uniquement de blancs donne une liste vide. Avec un séparateur explicite, même une chaîne vide contient un champ vide.
for text in ("", " ", "a b", "a\tb"): print(repr(text), text.split(), text.split(" "))print("A,,B,".split(","))$ python3 empty.py'' [] ['']' ' [] ['', '', '', '']'a b' ['a', 'b'] ['a', '', 'b']'a\tb' ['a', 'b'] ['a\tb']['A', '', 'B', '']Il y a trois champs entre les bornes de a b quand chaque espace compte : a, la chaîne vide, puis b. La même logique explique les quatre champs de A,,B,. Supprimer tous les champs vides ensuite peut détruire une information : dans une ligne à colonnes, le champ absent peut représenter une valeur manquante.
Que représente le séparateur ?
Des blancs entre des mots
text.split()
Regrouper espaces, tabulations et retours à la ligne, sans champs vides.
Un délimiteur exact entre des champs
text.split(sep)
Conserver les champs vides produits par deux délimiteurs ou par un délimiteur final.
Si ton format est du CSV avec des guillemets et des virgules à l'intérieur d'une valeur, utilise le module csv. split(",") ne sait pas interpréter ces guillemets. De même, un séparateur à plusieurs caractères est une séquence entière, pas un ensemble de caractères possibles.
split() reconnaît-il les tabulations et les espaces insécables ?
Sur une chaîne str, les caractères d'espacement reconnus comprennent l'espace insécable U+00A0. Le caractère de largeur nulle U+200B n'en fait pas partie. Pour diagnostiquer un caractère invisible, regarde sa représentation et teste isspace().
text = "a\u00a0b\u200bc"print(repr(text))print(text.split())print(text.split(" "))print("\u00a0".isspace(), "\u200b".isspace())print(text.encode("utf-8").split())$ python3 unicode.py'a\xa0b\u200bc'['a', 'b\u200bc']['a\xa0b\u200bc']True False[b'a\xc2\xa0b\xe2\x80\x8bc']Le premier découpage sépare a de b, mais garde b et c ensemble autour de U+200B. N'efface pas les caractères invisibles sans vérifier le format que tu traites.
La dernière ligne travaille sur des octets UTF-8 : bytes.split() sans argument reconnaît les blancs ASCII, pas tous les blancs Unicode. Décoder des données textuelles avec leur encodage avant de les découper évite de confondre ces deux règles. Un encodage inconnu reste un problème à résoudre à la lecture.
maxsplit nettoie-t-il le reste de la chaîne ?
maxsplit limite le nombre de découpages, pas le nombre de blancs supprimés partout. Après la dernière séparation autorisée, le reste est conservé. Avec maxsplit=0 sans séparateur explicite, seuls les blancs initiaux sont ignorés.
text = " red blue green "print(text.split(maxsplit=1))print(text.split(" ", 1))print(text.split(maxsplit=0))print(text.strip().split(" "))$ python3 limit.py['red', 'blue green ']['', ' red blue green ']['red blue green ']['red', '', '', 'blue', '', 'green']Avec maxsplit=1, le deuxième élément garde ses deux espaces internes et ses deux espaces finaux. Avec un espace explicite, le premier espace suffit à consommer l'unique découpage : le premier champ est vide.
strip().split(" ") retire les blancs aux extrémités, mais ne regroupe pas les espaces au milieu. Pour une extraction complète de mots séparés par des blancs, split() suffit. Si tu veux conserver le reste d'une ligne après un premier champ, précise au contraire le comportement attendu avec maxsplit.
Comment vérifier les mots avant de les compter ?
Commence par inspecter la liste des mots, avant d'ajouter un dictionnaire de fréquences. Cela sépare une erreur de découpage d'une erreur de comptage.
text = "Row row\trow!\nRow"words = text.split()print(words)print(len(words))print(text)$ python3 words.py['Row', 'row', 'row!', 'Row']4Row row row!RowIci, len(words) compte quatre occurrences, pas trois mots distincts. La casse et la ponctuation restent intactes : Row, row et row! sont trois clés différentes pour un compteur qui compare les mots exactement. split() n'est pas un analyseur linguistique ; il ne retire ni ponctuation ni accents.

tally_words
Implémente tally_words : l'exercice définit les mots par les espaces, tabulations et retours à la ligne, puis demande leurs fréquences dans l'ordre de première apparition. Vérifie les blancs multiples et le texte vide avant de compter les répétitions.
Pour choisir l'accès au dictionnaire pendant le comptage, consulte KeyError et les clés absentes. Pour classer ensuite des résultats, continue avec le tri selon plusieurs critères. Ces étapes n'ont pas à changer la définition du mot fixée au départ.
Questions fréquentes
Faut-il appeler strip() avant split() ?
Pas pour un découpage complet sans argument : split() ignore déjà les blancs initiaux et finaux. Avec un séparateur explicite ou une limite, raisonne sur les champs que tu veux conserver.
split(" ") sépare-t-il sur une tabulation ?
Non. Il coupe seulement sur le caractère espace. Utilise split() si espaces et tabulations doivent jouer le même rôle.
Pourquoi une chaîne vide donne-t-elle parfois [''] ?
Avec un séparateur explicite, le résultat contient un champ vide. Sans séparateur explicite, aucun mot n'est trouvé et le résultat est [].
Peut-on compter les mots avec len(text.split()) ?
Oui si un mot signifie une suite de caractères non blancs et si tu veux le nombre d'occurrences. Cela ne compte pas les mots distincts et ne traite pas la ponctuation comme une séparation.
Sources